图片来源:北京日报 / 北京市政府网站
人工智能与数学的关系,正在从“用模型解题”进入“用模型参与研究”的新阶段。
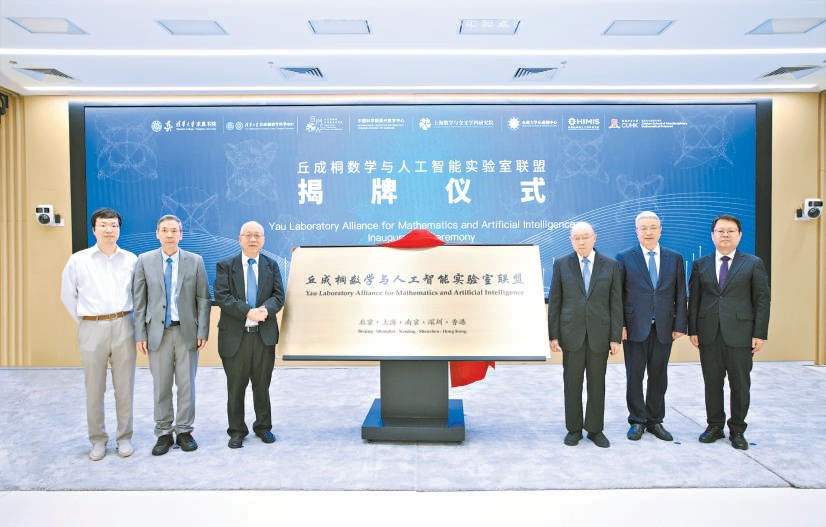
10 月 11 日,丘成桐数学与人工智能实验室联盟在清华大学成立。联盟由菲尔兹奖得主、清华大学求真书院院长丘成桐牵头,联合八家数学研究与人才培养机构,计划汇集超过 1000 名数学家和科研工作者,自主探索中国数学科学专用大模型。
联盟的目标不只是训练一个更会做竞赛题的模型,而是建设一套面向真实数学研究的基础设施:理解论文、生成猜想、规划证明、调用形式化工具、检验关键步骤,并把数学方法扩展到量子计算、生命科学和金融经济等交叉领域。
丘成桐将 AI 对数学的冲击形容为“海啸”。他的判断是,数学家不能躲避这股浪潮,而应建立自己的模型、数据、验证工具和研究规范,在 AI 重新塑造科研流程之前主动参与。
八家机构组成跨区域研究网络
联盟汇集的机构包括:
- 清华大学求真书院;
- 清华大学丘成桐数学科学中心;
- 北京雁栖湖应用数学研究院;
- 中国科学院晨兴数学中心;
- 上海数学与交叉学科研究院;
- 东南大学丘成桐中心;
- 河套数学与交叉学科研究院(深圳);
- 香港中文大学致真交叉数学科学院。
这些机构分布在北京、上海、南京、深圳和香港。首个数学与人工智能实验室设在清华求真书院,并与丘成桐数学科学中心共同运行;其他参与机构将陆续建设实验室,形成跨区域协作网络。
这类联盟的意义在于把数学专家、AI 工程团队、计算资源和研究数据集中起来。数学大模型需要的不只是通用文本语料,还需要高质量定理、证明、反例、形式化代码以及专家对推理过程的反馈。单一研究团队很难独立完成这些工作。
联盟明确的六项重点任务
根据公开信息,联盟现阶段将推进六项重点工作。
第一,研发数学科学专用模型。在借鉴国际通用大模型技术的同时,自主建设面向中国数学研究需求的模型体系。
第二,建设 AI 辅助数学研究基础设施。为数学家提供文献理解、证明辅助、计算实验和形式化验证工具,同时保护研究者尚未公开的原创成果。
第三,从基础数学支持 AI 可解释性和安全性。利用逻辑、概率、优化、几何和动力系统等理论,研究模型为什么得到某个答案,以及推理是否可靠。
第四,推动数学驱动的交叉科技突破。把“数学基础研究—AI 技术开发—领域应用”链条延伸到量子计算、生命科学、金融经济等领域。
第五,开展国际合作与人才培养。面向海外高校举办训练营、联合培养年轻人才,使数学家和 AI 研究人员能在同一研究语言下协作。
第六,建设专业学术出版平台。办好《Journal of AI-Assisted Mathematics》,为 AI 辅助数学成果建立同行评议、验证和学术署名机制。
数学专用大模型与普通大模型有什么不同
通用大模型擅长根据文本概率生成看似连贯的证明,但数学研究要求每一个关键推理都可以被检查。一个符号错误、遗漏条件或错误引用,都可能让整篇证明失效。
真正的数学研究模型需要组合多种能力:
数学文献检索 → 问题建模 → 猜想生成 → 证明规划 → 引理搜索 → 计算实验 → 形式化验证 → 人类审阅
其中,形式化证明系统尤为重要。Lean 等工具可以把定理和证明写成机器可检查的代码,由证明内核逐步验证逻辑是否成立。它不能保证研究问题有价值,也不能自动判断一篇论文是否具有原创意义,但可以显著降低“证明看起来正确、关键步骤却有漏洞”的风险。
数学专用模型还需要处理知识溯源。模型必须说明使用了哪些既有定理、论文和数据库,避免把前人的结论包装成新发现。对于尚未公开的研究,系统还要提供严格的数据权限和防泄漏机制。
OpenAI 数学手稿事件带来的现实压力
联盟成立的背景之一,是海外 AI 数学研究快速推进。OpenAI 近期集中公开 700 余篇由模型参与生成的数学研究手稿,覆盖数论、代数几何、理论计算机科学、流体力学和统计物理等方向。
这一事件一方面显示 AI 已经能够进入较复杂的研究流程,另一方面也引发了验证、错误率、署名和同行评议争议。部分手稿随后因证明问题被撤回或修改,公开材料中也只有一部分完成了形式化验证。
我们此前在“数学末日”:OpenAI 生成数百项数学成果,但谁能理解这些证明?一文中分析过,AI 生成大量候选成果后,数学界真正稀缺的资源可能从“提出证明”变成“理解、验证和筛选证明”。
中国自主建设数学模型,因此不能只追求论文或猜想数量,还需要同步建设验证体系和学术规范。否则,模型越高产,同行评议承担的噪声成本反而越高。
“中国数学大模型”为什么强调自主开发
数学研究模型可能接触尚未发表的论文、研究笔记、猜想和证明草稿。这些内容本身就是高价值科研资产。若研究者只能通过外部商业 API 使用模型,就会面临数据出境、访问中断、模型版本变化和研究成果泄露等风险。
自主开发并不等于完全脱离国际技术生态,而是要掌握几项关键能力:
- 数学语料和形式化数据集的治理权;
- 模型训练、微调与评估方法;
- 研究过程中的权限与保密机制;
- 可长期使用的计算和证明工具链;
- 能由数学共同体审查的评价标准。
只有把这些能力沉淀为公共科研基础设施,模型才不会只是少数团队的演示项目。
AI 会取代数学家吗
联盟参与者的判断并不是让 AI 代替数学家,而是重新分配研究工作。
AI 可以快速检索文献、尝试大量证明路径、寻找反例和完成机械验证;数学家仍需要提出重要问题、判断方法是否有意义、理解不同领域之间的结构,并解释一个结果为什么值得关注。
清华学者提出,数学教育也需要从训练计算和解题能力,转向培养好奇心、独立思考和与工具协作的能力。学生不能把模型输出直接视为知识,而要经过理解、验证和重新表达,把结果转化为自己的认知。
这也是数学与 AI 联盟真正值得关注的地方:它不只是追赶一个模型指标,而是在尝试重建数学研究的工具链、协作方式和人才培养体系。
未来可以通过五项指标判断联盟是否形成实质成果:
- 是否发布可供数学家实际使用的模型或研究 Agent;
- 是否建立公开、可复现的数学能力评测;
- 生成成果中有多少通过形式化和同行验证;
- 是否解决真实开放问题,而不只是复现已知结论;
- 是否形成跨机构共享但能保护原创的科研数据机制。
AI 给数学带来的“海啸”既可能扩大研究能力,也可能制造大量难以验证的内容。真正有价值的数学大模型,不是写出最多证明的系统,而是能帮助人类提出好问题、获得可靠答案并理解答案为何成立的科研基础设施。
原始报道: 联合早报:丘成桐牵头成立数学与 AI 实验室联盟
官方转载: 北京市政府网站:丘成桐数学与人工智能实验室联盟在清华大学成立
任务与机构信息: 新京报:丘成桐数学与人工智能实验室联盟成立